出品 | 虎嗅科技組
作者 | 梁卡爾
編輯 | 苗正卿
頭圖 | 華爲官網
長期以來,英偉達憑借先進制程和CUDA生態深刻影響全球AI進程。但當大模型參數向10萬億甚至40萬億飆升時,單顆芯片越來越難以獨立支撐,AI算力競爭更依賴系統架構與互聯能力。在制程受限背景下,華爲試圖給出系統級方案,通過架構與互聯創新,讓百萬顆處理器像一臺計算機一樣工作。
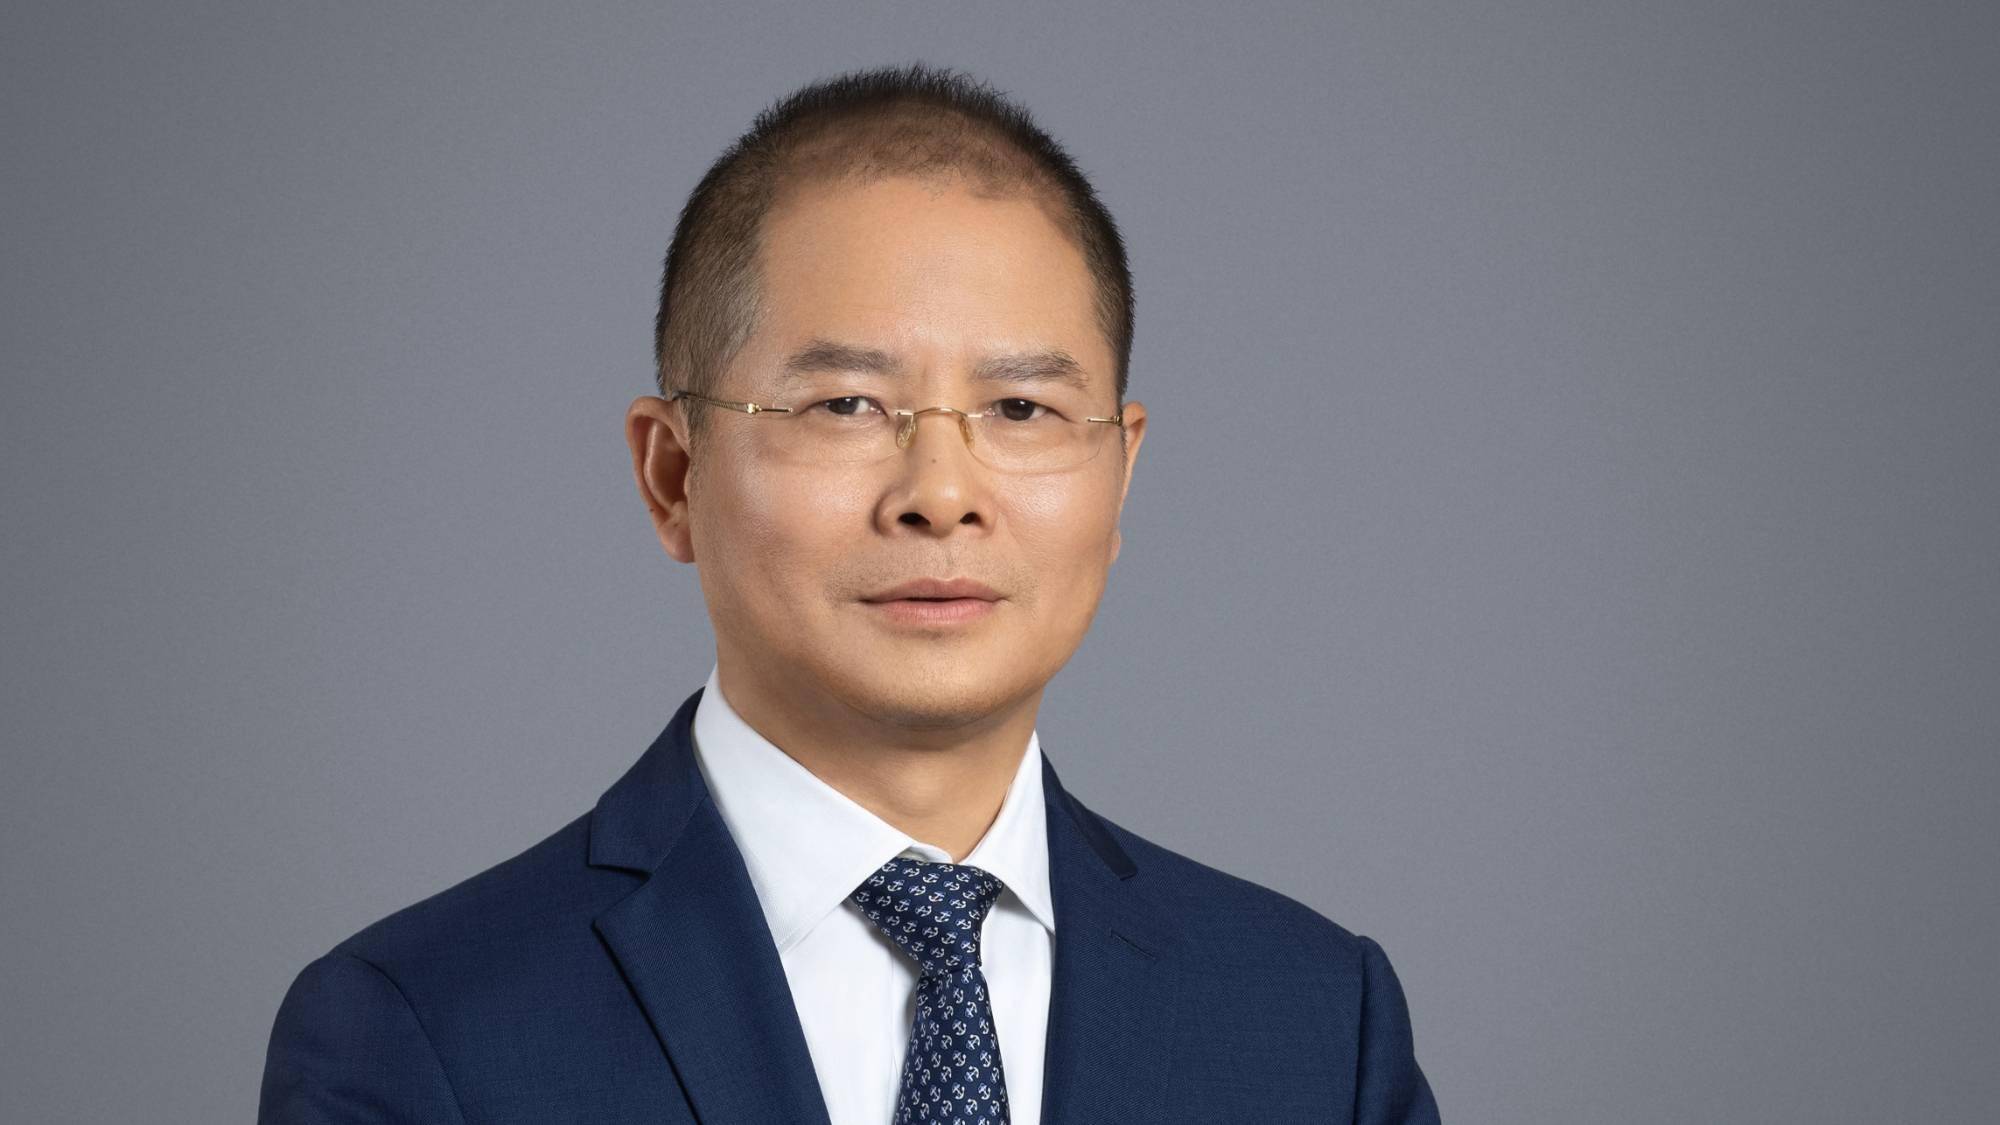
9月,華爲全聯接大會期間,華爲輪值董事長徐直軍與海思首席科學家廖恆對外披露了華爲的底牌,Peerium計算架構與靈衢總線(UnifiedBus,簡稱UB)。他們試圖打破圖靈範式的串行限制與馮·諾依曼的主從架構,並透露在可統計的數據中,昇騰在中國市場的佔有率已超越英偉達。
過去,行業普遍遭遇的痛點是,單顆芯片算力極強,但成千上萬顆芯片組合成集羣時,由於通信延遲和協議轉換,整體算力效率會發生斷崖式下跌。行業通常的方案是打補丁。比如,英偉達分別構建了櫃內的NVLink和櫃外的InfiniBand網絡,但這種“多協議轉換”在跨櫃、跨區域時會帶來微秒級的延遲開銷。
對此,徐直軍稱,在單芯片設計上華爲沒有問題。雖然仍受制於國內制造工藝,但通過多芯片互聯將系統變成爲一臺計算機,在這方面,華爲已經處於全球領先地位。這背後是兩個核心技術的突破:一個是Peerium計算架構,它通過嵌套並行與統一內存尋址,改變了主從架構,實現了百萬級處理器的強擴展性;另一個是靈衢總線。
靈衢的改變在於,它用統一開放協議“把網絡當成了總線來做”。它消除了傳統方案中繁瑣的協議轉換,UB採用統一協議,數據包從scale-up網絡傳輸到scale-out網絡約需150納秒,相比協議轉換開銷節省一個數量級。物理上分布在不同機櫃的百萬顆芯片,在邏輯上像一臺計算機一樣工作。
此外,華爲發布了基於NPO(近芯片光傳輸)的Hi-ONE同樣值得關注。華爲選擇了內置光源方案,相比CPO方案成本降低接近40%,且光引擎一旦出問題,不會把整個AI芯片一起報廢。這是一種工程務實選擇和成本之間的折中。徐直軍預計,未來兩到三年內都很難有其他廠商能做出來。
在這背後,軟件生態的“CUDA壁壘”也在消解。廖恆博士指出,過去18個月大模型正變得非常細粒度,新編譯器語言的出現正在逐步取代並拉平昇騰與英偉達的軟件差距。過去國內廠商不用國產芯片,最大的顧慮是軟件生態不好用。這種底層編程範式的轉移,可以給國產芯片創造一個軟件破局窗口期。
面對市場需求,徐直軍表示,“未來的關鍵不在於我們推動的力度有多大,而在於我們的供貨能力有多大”。目前,20萬卡左右的超級集羣已成爲中國前沿AI實驗室訓練超大規模基礎模型的剛需,昇騰芯片正處於“產多少、供多少”的供不應求狀態。中國頭部模型廠商也在衡量了算力效率、原廠工程服務以及大模型剛需後的市場化選擇。隨着年底新芯片的規模釋放,國產算力瓶頸將進一步松動。
以下是大會期間媒體圓桌交流的問答摘要:
Q:廖博論文裏面寫的25.6萬張卡組成一個超節點,這是該技術的上限嗎?目前整體市場需求情況如何?
廖恆:25.6萬或約20萬這個數字,並不是隨便定的。
首先,這類大型集羣用於訓練,硬件基礎設施需要支撐基礎模型訓練,而目前模型參數規模已達到5萬億級別。
未來兩年內,預計中國將出現約6至7個前沿AI實驗室,目標都是訓練參數規模在10萬億到40萬億之間的基礎語言模型。這些數字與超節點的內存容量和規模大致匹配,因此需要如此規模的基礎設施來做訓練。
第二,在中國,大多數數據中心都接入了國家電網。考慮到單個區域、單個數據中心園區的電力輸送系統設計,20萬是一個相對保守的數字。
正如我所說,大家一定對全球範圍內正在發生的AI模型競賽非常熟悉。在中國,至少有3到4家一線參與者已獲得廣泛認可,並達到了一線地位。
Q:華爲接下來將如何推動中國的模型廠商將昇騰系列芯片用於訓練?
徐直軍:950 率先推出的是PR版,主要面向推理,目前上市量不算大。基於950DT的超節點則主要用於訓練,目前還在測試中,規模供貨應該在今年年底或明年初。我們和各家模型廠商做了很多溝通交流,從目前測試結果來看,950DT 的訓練表現非常不錯,我相信從明年開始,大量模型的訓練會構築在950DT超節點上。未來關鍵可能不在於我們推動的力度有多大,而在於我們的供貨能力有多大。現在能產多少就供多少,我們希望產業鏈加快擴產,快一點、多產一點。
Q:現在美國部分領先模型廠商呼籲放緩AI產業的發展,對此華爲怎麼看?
徐直軍:從中美AI發展的水平和節奏來看,中國的模型基本都是開源的,相對而言,發展到哪一步也是透明的;而美國幾家主流模型廠商由於擁有更強大的算力,到底發展到了哪一步,目前可能只有他們自己知道。他們感受到的AI風險,在中國可能感受並不強烈。中國現在還是要加快自己的節奏,等真正能夠感受到這種風險時,或許會與美國頭部模型廠商有同樣的感覺。但我一直認爲,AI既要發展又要管控風險,要讓AI“向善”,而不是“向惡”。
Q:950超節點目前有沒有在海外擴展的計劃?如果有的話,會在哪些市場上開展?國內市場份額情況如何?如何看待芯片自主化率的問題?
徐直軍:目前昇騰滿足國內市場需求還遠遠不足,所以沒有全面拓展海外市場的計劃。但確有少數國家非常需要,我們做了測試和供給,但量非常少。
在中國市場要統計英偉達的市場佔有率很難,但如果從我們能夠統計到的數據看,昇騰應該已經超過了英偉達。
中國推進芯片自主化是一條必然之路。中國有14億人口,又是一個工業化大國,所有的生活、工作都與芯片相關。中華民族又是一個憂患意識很強的民族,不能一直受制於人,不能今天被說賣一顆給你,明天又說不賣給你。盡管水平差一點、先進性差一點,但解決“有無”問題,不要天天提心吊膽,應該是必然之路。相信無論是中國政府還是中國產業界,包括華爲在內,推動芯片的全面自主化、推動半導體產業整個鏈條的全面自主化,肯定是一條必由之路,而且我也相信總有一天會變爲現實。
Q:華爲推出了靈衢互聯技術,是基於在計算和通信領域的長期積累,其中有多少是來自華爲網絡部門的貢獻?
徐直軍:UB不僅僅是華爲網絡部門的貢獻,我們在各種各樣的互聯協議基礎上,最終將其做成一個統一協議。網絡領域一般是IP協議,時延都很高。計算互聯和傳統網絡不一樣,我們提的是總線,需要低時延、超高速。當時在決策做這個產品時,我們將其放在計算部門而不是傳統的網絡部門,這樣才能真正做出一個高速、低時延、又統一協議的UB出來。
廖恆:如果把UB看作一羣人的智慧結晶,它是由計算機架構師孕育,但是由網絡技術撫養長大。
Q:UB是一個同時兼顧Scale-out和Scale-up的技術。英偉達分別做了NVLink和InfiniBand。爲什麼華爲把Scale-up和Scale-out做成一個技術?這和現在其他方案相比有什麼優勢?
徐直軍:首先,不是他們不做,而是能不能做出來的問題。當前最新的NVL72櫃內帶寬很寬,達到1.8TB/s,但一出櫃就降到0.2TB/s。要把百萬臺處理器變成一臺計算機,櫃間如此低的帶寬根本不可能。大家都希望櫃內、櫃間、數據中心之間乃至跨區,速度最好都一樣,那才能讓一個巨大的物理空間成爲一臺計算機。這正是 UB 的價值,它基於一個統一協議,做到全程高速互聯。因此UB技術路線上做的是總線,就像計算機內部的總線一樣,而不只是Link。基於UB,我們的櫃間帶寬最高可達800GB/s。
去年我們開放UB協議後,最大的下載量其實來自硅谷。英偉達最早的目標可能不是做NV72,而是NV256,但最終它的256變成了72;而華爲的910C 超節點做到了384,還交付了一千多套。最主要的差別在於,我們在910C超節點上採用了UB,而當時英偉達的NVLink主要局限於櫃內,櫃間網絡速度太慢,不可能擴展太多。
廖恆:我補充一下爲何採用單一協議。英偉達及大多數其他廠商至少使用了兩種協議,分別應對不同的場景,就像一次旅行往往要同時選擇飛機、高鐵、汽車等多種交通工具,轉換過程相當麻煩費時。而在這些超節點中,大量流量需要中轉,如果從NVLink切換到InfiniBand,至少涉及微秒級的轉換時間,即從一個協議到另一個協議的中轉時間,時延很難滿足。
UB採用統一協議,將數據包從scale-up網絡傳輸到scale-out網絡,可能只需要大約150納秒。相比而言,與這些協議轉換開銷至少可節省一個數量級。
Q:在採用UB的Atlas 950中,Scale-up場景下光互聯和電互聯分別佔多少?未來櫃內有沒有可能全部實現光互聯,主要障礙是什麼?
徐直軍:華爲剛剛發布了基於NPO的Hi-ONE模組,支持7.2T高帶寬,光引擎距離主芯片僅約5釐米,只有這部分還需要銅線做電連接,基本可以說是全光的超節點。同時,Hi-ONE模組把光源直接封裝進模組內部,實現內置光源。我們預計,未來兩到三年內都很難有其他廠商能做出來。這是華爲多年來在光電相關領域的積累,才得以實現和量產。
廖恆:在我職業生涯初期,20年多前我們就已經在討論讓芯片連接走向光學化。因爲光的傳輸距離和衰減非常小,信號可以高速傳輸更遠。
從電路角度看 Hi-ONE 內部其實非常簡單,器件並不多。但走向量產這條路,我們走得非常艱難:光學技術涉及大量物理原理,溫度稍微變化,就會影響二極管的物理特性,改變折射率,影響波導性能,導致無法正常工作。
我認爲全光互聯最大的障礙是對可靠性的擔憂,因爲器件會發生故障。目前大多數廠商選擇外置光源路線,用單個光源饋送32路信號,功率就必須放大32倍。如此巨大的功率很容易引發許多問題,在耦合接口及其他各個環節都會出問題。我們選擇內置光源方案,是出於工程上的務實選擇,Hi-ONE正是經過多次權衡後達成的出色折中方案,很快將進入量產階段。
Q:關於昇騰芯片的工藝和產能問題,目前限制產能進一步釋放的主要瓶頸是哪些環節?華爲預計還需多久可以實現大規模穩定的算力芯片供應?
徐直軍:中國的瓶頸問題與全球瓶頸問題基本一致。全球產業界都沒有爲AI如此浪湧式的發展做好準備。現在所有光模塊公司、存儲公司之所以能賣高價,並不是因爲產品有多好,而是嚴重供不應求所致。因此,只有全球和中國同時達到供需平衡,瓶頸問題才能徹底結束。我預計全球的供需平衡差不多在2029年能得到解決,中國可能還要慢一點。這裏的供需平衡,還要考慮AI發展過程中不斷發生的技術變化,包括CPO、NPO等。
從華爲的角度講,相比過去的通信、IT產業,現在我們的供應量已具備相當規模;但如果和當前產業對AI基礎設施的需求相比,規模確實又遠遠不夠。要實現客戶要多少就能供多少,華爲要達成這個平衡,取決於整個中國產業界的平衡。
Q:有報道說馬來西亞正在考慮基於華爲昇騰910C來部署主權AI,華爲如何來平衡國內客戶和海外客戶的需求?
徐直軍:從客戶部署華爲解決方案的選擇來看,肯定是基於地緣政治和多供應商的考量。每個企業都要爲其長遠發展消除安全風險,因此昇騰必然是所有客戶的一個選項,盡管相比競爭對手它還有差距。至於平衡國內與海外,我們的原則很簡單:國內爲主,優先供應急需算力的中國客戶;海外則服務於少數買不到的客戶,或一定要另一個選擇的客戶。
Q:華爲在NPO、CPO這兩個技術路線上,當時內部選擇或者博弈是什麼?
徐直軍:這個問題在華爲好像沒有過爭論。因爲華爲既做光器件,又做光模塊和昇騰芯片,清楚哪種情況才是最佳選擇,所以我們很早就達成共識做NPO,沒做CPO。而且我認爲,在相當長時間裏,從工程實現、成本、維護、良率等角度講,NPO都是最佳選擇。
經過產業界這幾年關於NPO、CPO的辯論,從兩次OIF的討論來看,產業認知也在進一步清晰。OIF第一次討論時,有一部分廠家不支持NPO,一心要搞CPO;而最近一次NPO立項時,反對的已經寥寥無幾。相比CPO方案,NPO的銅線連接有5釐米左右,比CPO的5毫米左右要長一點,但帶來了成本接近40%的下降,同時還帶來另一個好處,即一旦光引擎出問題,不會把整個AI芯片一起報廢。當然,CPO和NPO並不是誰消滅誰的問題,而是工程、成本、產業鏈、維護等各個方向上平衡的選擇,沒有對錯。
所以,我們堅定不移走NPO的道路,推動產業界形成標準,全產業鏈共同把NPO發展好,但也不是說CPO不行。在OIF上NPO得到了40家產業鏈廠商的支持,應該來講,大家也看到了NPO的好處。
Q:模型廠商對於950DT用在模型訓練上,給華爲反饋了哪些需要改進的領域和問題?華爲對大模型的預訓練做了哪些芯片和底層方面的調整和優化?
廖恆:此前昇騰芯片遇到的第一個障礙其實並非硬件本身,而主要是生態壁壘。就在兩年前,昇騰軟件層面仍存在巨大障礙,而CUDA在這方面顯然具有壓倒性優勢,因爲整個學術界都是伴隨CUDA成長起來的,所有算法開發者都已習慣了PyTorch加CUDA的便利。
過去18個月發生了巨大變化。首先,模型的數學復雜程度發生了巨大變化,編程復雜度也隨之增加。其次,模型正變得非常細粒度,這意味着無法再僅用PyTorch編寫程序並保持效率。因此,即便是算法開發者,也必須轉向超大規模內核的編程風格,需要新的編程語言,這已經是前沿實驗室的發展方向。
如今,隨着新的編譯器語言出現,它們正在逐步取代並平衡CUDA的壁壘,前沿實驗室已不再像兩年前那樣重視CUDA。這是軟件層面的壁壘消解。我認爲我們正在接近甚至達到平衡,差距已大幅縮小。
其次,關於芯片本身,我們擁有自身優勢,正如我講到的UB和Nested BSP模型。這不僅是對單個芯片編程,更是以便捷的方式對大量芯片編程,我們正在提供這些能力。而在芯片內部,我們也吸取了此前的教訓,做出了大量改進。
整體上,我們正在縮小英偉達與昇騰之間的差距。我認爲如今主要差異已大幅縮小,當人們使用這些處理器開發時,不再感到陌生。
Q:關於UnifiedBus技術,這是國內在先進制程受限情況下走出的中國特色路線,還是未來全行業都可能的方向,英偉達也有可能往這個方向走嗎?
徐直軍:UB是一條創新之路,我認爲也是未來AI計算的必由之路。
因爲只有UB這種互聯技術,才能實現百萬級處理器的巨大計算機。而上百萬的處理器像一臺計算機一樣工作,才能真正實現更好、更高效率的訓練和推理,所以它是必由之路。相信過不了幾年,大家都會朝着這條路走。
爲什麼開放UB協議?就是因爲相信整個產業界會朝着這條路線走。這樣,爲AI走向AGI,需整個產業界共同努力。廖博爲什麼以論文形式公布Peerium計算架構,也是因爲這一創新架構就是AI時代的計算架構。960只是節奏變快了,規格和我去年講的一樣;HBM是在960裏面的,沒有HBM的進步,也沒有960的進步。
今天UB互聯技術是整個Peerium計算架構實現的基礎。無論是UB互聯技術還是Peerium計算架構,我們都認爲是AI時代的未來之路。
我多次講過,在單芯片上,我們的設計沒有任何問題,只是仍受制於國內的工藝。但將多芯片互聯起來成爲一臺計算機,我們已經處於全球領先的地位。這是基於架構的創新和互聯技術的創新,而且這些研究工作不是在制裁後才開始的,而是在制裁之前就開始了。第一顆AI芯片以及華爲的整個AI戰略,是我在2018年HC大會上發布的;2019年,我們發布了超節點和集羣。自那以後我們就認爲,AI要支撐大規模的訓練和推理,需要新的架構、新的互聯技術,也是從那時開始不斷投入研究、不斷創新,才有了今天講的創新計算架構和UB互聯技術。
相關閱讀
- 川普取消限制後,燃料產業警告卡車停靠站不要販售「紅色染料」柴油2026-10-08
- 原創 特努斯上任抓設計,蘋果10月密集上新,一場用硬體自救的戰略大轉向?2026-10-07
- 中國最大餃子IPO來了2026-10-07
- 萬億砸向高速充電樁,排隊為何仍是無解?2026-10-07
- 迪士尼每年都会提高公园的价格。以下是避免家庭定价的方法2026-10-06