新智元報道
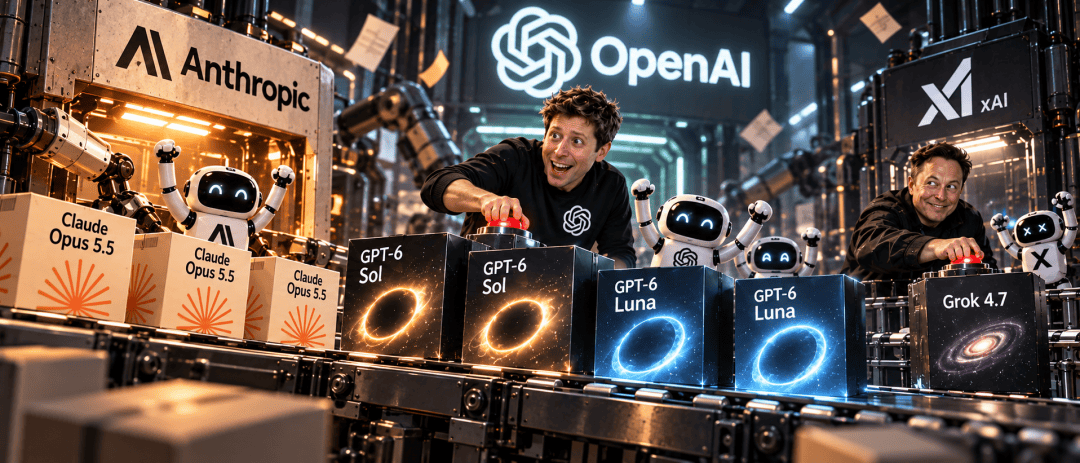
太瘋狂了,短短兩天,竟然冒出了4個新模型!
前腳,老馬的xAI才剛發完Grok 4.7。
緊接着,OpenAI突然甩出GPT-6 Sol和Luna,價格直接腰斬。同一天,Anthropic也把Claude Opus 5.5拍在了桌上,比上一代硬生生便宜40%。
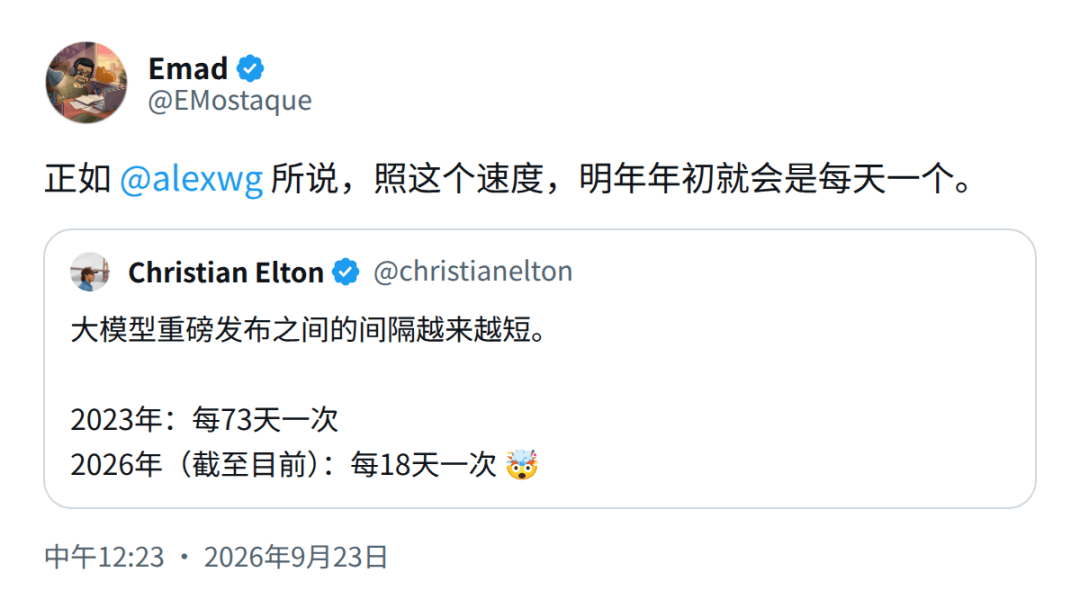
9月22日,一張動圖在X上被轉瘋,瀏覽量狂飆近百萬。
2023年,大模型73天一更,到了2026年,18天一更。
從ChatGPT上線算起,OpenAI和Anthropic已經狂轟濫炸了42個重磅模型(算上當天發的GPT-6 Sol和Luna是44個)。
幾小時後,Stability AI創始人Emad Mostaque轉發了這張圖,還加了一句預言。
「就像Alex說的,照這個速度,明年年初就是每天一個。」
兩大巨頭,卷出「半月一更」
其實,「18天一更」這個數還算保守,因爲它只算了OpenAI和Anthropic兩家。
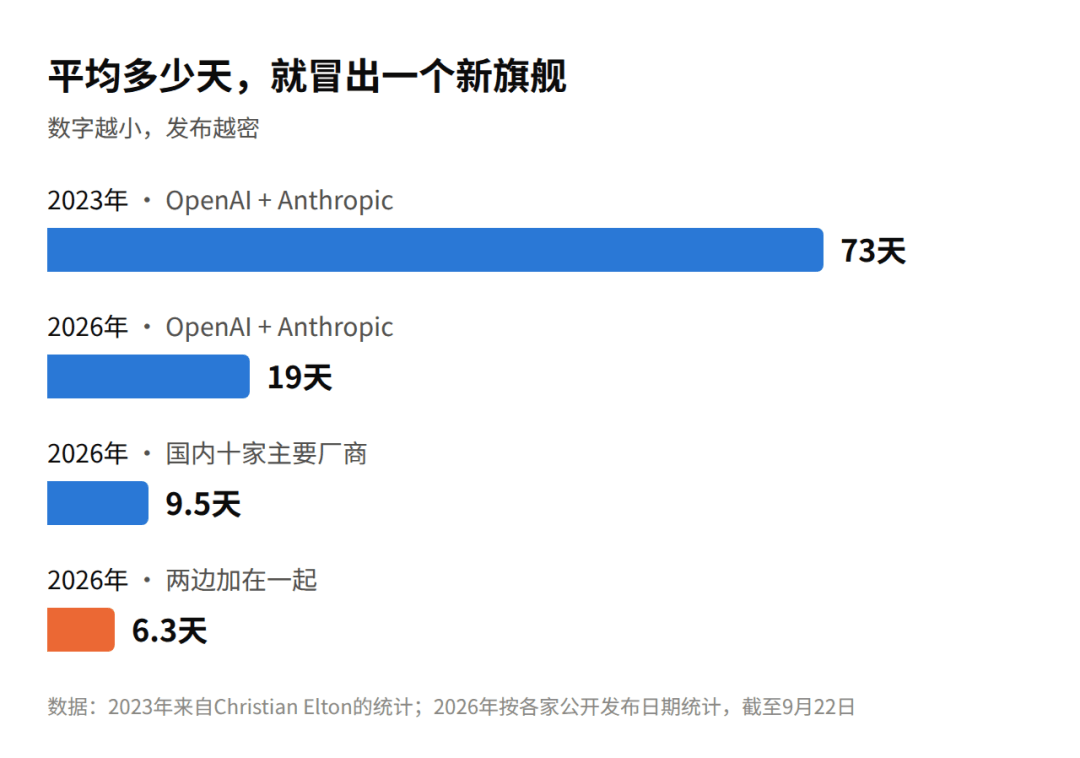
今年初到9月22日,Anthropic發了8個旗艦模型,OpenAI發了6個,14個模型攤進265天,平均19天一個。
同一時間段裏,國內十家主要大模型廠商又發了至少28個旗艦,平均9天多一個。
有幾回還是扎堆發的,春節前一周,4家接連甩出新旗艦;4月20日到24日,5天裏又是4家輪番上陣。
兩邊加在一起,平均6天多就冒出一個新旗艦,離Emad說的「一天一個」已經不算遠了。
Anthropic的提速肉眼可見。
上半年它平均46天發一個模型,下半年壓到了26天。Opus 4.8是5月28日,Opus 5是7月24日,Opus 5.5是9月22日。
OpenAI走的則是「憋大招,然後一套帶走」的路線。
9月3日GPT-6 Astra剛把全網炸翻,才隔了19天,Sol和Luna就跟着下場。
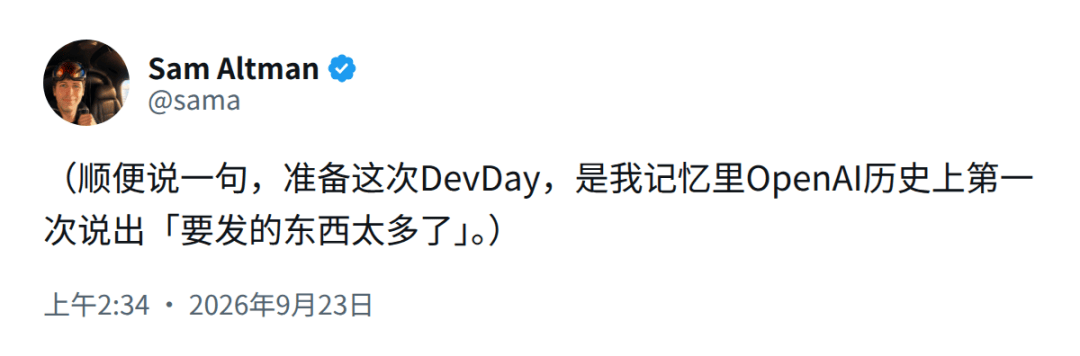
下周還有DevDay大會,Altman感慨,這是他記憶裏OpenAI頭一回在備戰發布會時喊出「要發的東西太多了」。
發布爲什麼越來越密,Anthropic在一份報告裏給出了答案,AI已經在幫着造下一代AI。
今年2月,Claude能獨立主導的AI研發工作還不到1%,之後幾乎一個月上一個臺階,5月12%,7月22%,到了8月已經達到了26%。
OpenAI那邊,截至8月中旬,AI智能體投入的工作日,已經是人類研究員的3.1倍(按每天8小時折算)。
在Anthropic,造模型的活,四分之一已經交給了Claude自己。下一個模型,只會一個接一個地來。
排隊的已經堵到了門口。Anthropic的Mike Krieger放話,Sonnet 5.5和Haiku 5.5未來幾周就到。
谷歌的Gemini 4早在7月就開始了「迄今最有野心的一次預訓練」,外界普遍押在年底前後亮相。國內也至少有兩家官宣了下一代旗艦,只差一個發布日期。
辛辛苦苦攢的「玄學」
兩個月直接報廢
大模型跑得越快,在下遊寫代碼的人就越狼狽。
你7月底熬了幾個通宵,剛把應用遷到Opus 5,參數一項項調得如絲般順滑。兩個月後Opus 5.5橫空出世,你滿心歡喜地一換接口——咔,一部分請求直接報錯。
把這兩家最近的官方提示詞指南翻一遍,會發現他們在傳達同一個事實,你給上一代模型寫的那些祖傳Prompt,很多都成了廢紙。
頭一件事是做減法。
OpenAI在Astra指南裏明說,以前太細的流程指令,現在反而會拖後腿,「改代碼前先通讀文檔」「切記跑測試」這種話,統統可以刪掉。
Anthropic的指南也是這個意思。
以前的提示詞裏常要加一句「做完檢查一遍」,可Opus 5已經會自己檢查,這句不刪,它反而會過度檢查。
到了Opus 5.5,聊天場景裏「回答前仔細想想」這種PUA話術也建議刪掉,刪了之後回復快了,質量也沒有明顯下降。
刪完舊的,還得補新的,因爲每一代都有新脾氣。
Opus 5.5在多輪對話裏老愛回頭琢磨已經答完的問題,白白浪費算力,官方給了一句補丁,「已經答過的,就當過去了。」
參數和默認值也在悄悄變。
在Opus 5.5上,關掉思考模式的寫法直接報錯400;不寫effort參數,默認檔位從high降到了medium,成本和效果跟着洗牌。
對此,官方的建議是重新跑一遍effort測試,別把Opus 5的老設置直接搬過來。
一套提示詞加一套參數,每一代都得扒層皮。調沒調過,賬單能差出一大截。
Anthropic的Lance Martin在視頻裏演示過,一份給Opus 4.8寫的老提示詞,每張工單成本2.45美分,直接換上Opus 5.5是2.02美分;再用官方工具洗一遍,準確率拉到92.0%,成本壓到了1.83美分。
除了這些,模型本身的壽命也在縮短。
今年OpenAI已經發了9次棄用公告,涉及40多個模型和功能。
其中,4月23日剛發的GPT-5.5,10月14日就要從ChatGPT和Codex下架,活了不到半年。
甚至,就連OpenAI自家的Evals評測平臺,也要在11月底關門。
刷榜?一套新考題,半年就被錘穿了
人跟不上就算了,現在連「考卷」都不夠用了。
今年3月,號稱專治AI、考智商不考背題的ARC-AGI-3上線。當時排第一的Gemini 3.1 Pro只拿了0.37%,人類是100%。
9月3日,GPT-6 Astra殺進考場,標準測試拿下62.7%,換上特定框架直接到了99.9%。在96%的關卡裏,它用的步數比人類還少。
一套新考題,半年就被打穿,ARC官方已經開始琢磨下一代評測該怎麼出。
寫代碼榜單(Next.js)上,Sol、Opus 5.5和Fable 5.1全是97%,並列第一;寫作榜單上,Opus 5.5斷層領先第二名307分。
這一分數是榜單有史以來最大的一次單次跳躍,博主看完直呼離譜,差點以爲是自己的基準出了bug!
新模型每來一個,開發者就得像西西弗斯一樣,把測試流程從頭再推一遍。
照現在這個節奏,明年要是真到了「一天一更」的地步,你今天調好的提示詞、配好的Agent鏈路,壽命可能都撐不過一個星期。
模型換代的速度,第一次徹底超過了人類適應它的速度。
如今跑得最慢的,竟然是使用AI的人。
參考資料:
相關閱讀
- 平均6天一個新旗艦!大模型更新快到人類跟不上了2026-09-26
- 原創 國產APP的病,要靠iPhone來治?2026-09-26
- 越来越多的人派遣人工智能来打客服战2026-09-25
- 為什麼問界“專屬專營”是時代的選擇2026-09-25
- 誰來阻止賽博洪水淹沒世界?2026-09-25